O conteúdo desse artigo usa o SQLite como exemplo, mas o funcionamento é quase o mesmo para outros bancos de dados SQL como PostgreSQL e MySQL.
Um índice no SQLite é uma estrutura extra, guardada junto da tabela, que deixa o banco encontrar uma linha sem precisar ler a tabela inteira. Você cria com CREATE INDEX nome ON tabela (coluna), confere se a consulta está usando com EXPLAIN QUERY PLAN e remove com DROP INDEX. Para mostrar a diferença de verdade, todos os exemplos abaixo rodam num banco com dados falsos gerados com a biblioteca Faker: quase 880 mil usuários, 17 milhões de certificados, 1 milhão de produtos e 75 milhões de aulas concluídas, num arquivo de quase 5,8 GB, porque é só com volume que dá para sentir o impacto de um índice. Cada tabela aparece com a estrutura dela na seção em que é usada.
O que é um índice no SQLite
Um livro é um exemplo perfeito para entendermos os índices. Quando você quer ler o capítulo 12, você não folheia página por página até encontrar, você vai no índice, vê que o capítulo 12 começa na página 430 e vai direto para ela. O índice do banco de dados faz a mesma coisa com as linhas de uma tabela.
Assim como no SQL, o índice do livro também não é de graça. Ele ocupa uma página, que é pouca coisa, mas ocupa. E se você acrescentar páginas no capítulo 10, vai ter que atualizar o índice inteiro dali para frente, porque o capítulo 12 não começa mais na página 430. O índice do SQLite tem exatamente esses dois custos, espaço e trabalho extra toda vez que os dados mudam.
Antes de criar qualquer índice, é bom saber que o SQLite já cria alguns sozinho. Toda coluna UNIQUE e quase toda PRIMARY KEY ganham um índice automático. Por que ele faz isso? Porque essas colunas não podem ter valor repetido, e a cada INSERT o banco precisa responder rápido a pergunta “já existe um usuário com esse e-mail?”. A forma rápida de responder isso é com um índice.
A tabela de usuários usada nos exemplos tem esta estrutura (resumida):
CREATE TABLE "users" (
"id" INTEGER PRIMARY KEY,
"name" TEXT,
"email" TEXT UNIQUE,
"email2" TEXT,
"vitalicio" INTEGER,
"created" TEXT
);| id | name | email2 | vitalicio | created | |
|---|---|---|---|---|---|
| 2 | Gael Melo | gael.melo93@example.com | gael.melo93@example.com | 1 | 2028-11-25 20:43:59 |
| 3 | Ana Júlia Carvalho | anajulia.carvalho7153@example.com | anajulia.carvalho7153@example.com | 0 | 2021-09-07 05:50:03 |
| 4 | Maria Alice Xavier | mariaalice_xavier2895@example.com | mariaalice_xavier2895@example.com | 0 | 2024-10-04 11:06:45 |
A coluna email2 é uma cópia do email, com os mesmos valores, mas sem o UNIQUE. Ela existe só para comparar a mesma busca com e sem índice.
Scan e search no EXPLAIN QUERY PLAN
Buscar o usuário de id 1 ou o de id 50000 leva o mesmo tempo, cerca de 1 milissegundo (na minha máquina de teste, Macbook M1). Isso já mostra que o banco não está passando linha por linha perguntando “é esse o 50000?”. Para saber o que ele fez, você coloca EXPLAIN QUERY PLAN na frente da consulta, e o SQLite devolve o plano que ele usou em vez dos dados.
SELECT * FROM "users"
WHERE "id" = 50000;
EXPLAIN QUERY PLAN
SELECT * FROM "users"
WHERE "id" = 50000;
-- SEARCH users USING INTEGER PRIMARY KEY (rowid=?)O EXPLAIN QUERY PLAN devolve algumas colunas, e a que interessa é a detail, com o texto do plano. SEARCH quer dizer que ele visitou só uma parte das linhas, e USING INTEGER PRIMARY KEY diz como: pela chave primária. A busca por e-mail segue o mesmo caminho, e o plano mostra o nome do índice automático que o UNIQUE criou.
EXPLAIN QUERY PLAN
SELECT * FROM "users"
WHERE "email" = 'lara.pereira6863@example.com';
-- SEARCH users USING INDEX sqlite_autoindex_users_1 (email=?)Agora a mesma busca no email2, que não tem índice nenhum:
SELECT * FROM "users"
WHERE "email2" = 'lara.pereira6863@example.com';
-- cerca de 90 ms
EXPLAIN QUERY PLAN
SELECT * FROM "users"
WHERE "email2" = 'lara.pereira6863@example.com';
-- SCAN users| id | parent | notused | detail |
|---|---|---|---|
| 2 | 0 | 216 | SCAN users |
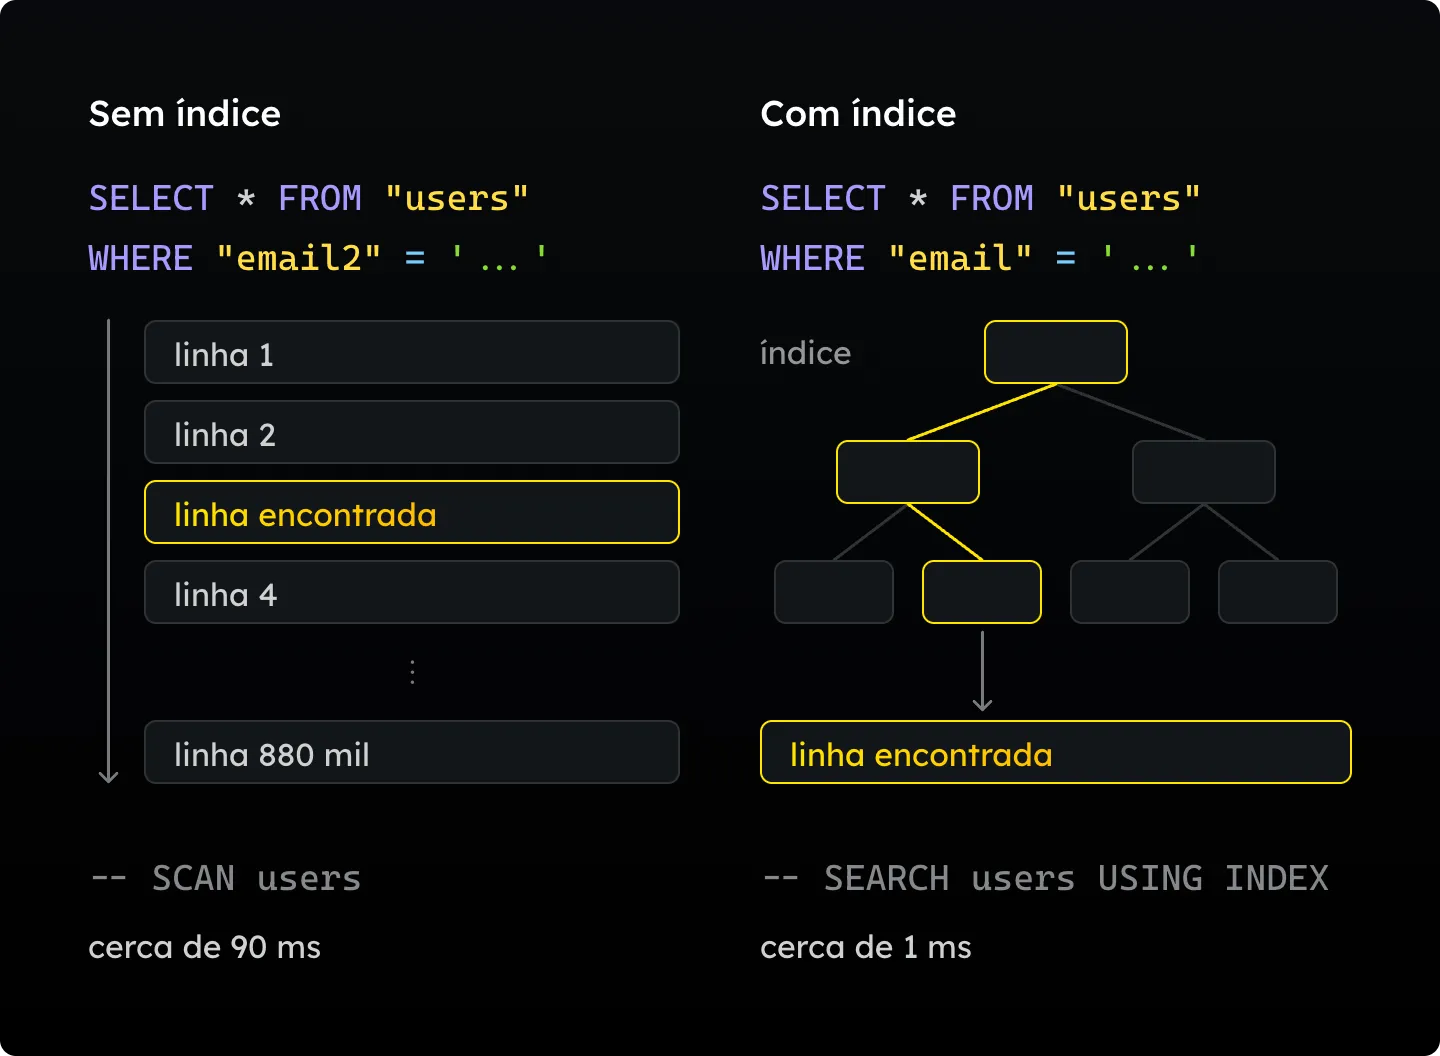
SCAN users quer dizer que ele leu a tabela inteira. Entrou na primeira linha, comparou o email2, não era, foi para a segunda, e assim nas quase 880 mil (desse banco de teste). E ele não para quando encontra, porque a consulta não tem LIMIT e nada garante que não exista outro usuário com o mesmo email2, então ele vai até o fim. A busca por created, a data exata em que o usuário foi criado, dá o mesmo resultado, por volta de 80 ms e SCAN users, porque também não existe índice nessa coluna.
Esses tempos dependem do programa e da máquina que você usa, então não se apegue ao número. O que interessa é que 1 ms é bem mais rápido que 90 ms. Pode parecer pouco, mas 90 ms é uma consulta muito lenta para um site. Imagina milhares de pessoas acessando ao mesmo tempo, cada uma disparando essa consulta, e cada consulta levando 90 ms. Isso praticamente trava o site.
| Busca | Plano | Tempo |
|---|---|---|
id = 50000 | SEARCH users USING INTEGER PRIMARY KEY | ~1 ms |
email = '...' | SEARCH users USING INDEX sqlite_autoindex_users_1 | ~1 ms |
email2 = '...' | SCAN users | ~90 ms |
created = '...' | SCAN users | ~80 ms |
Por que o índice é mais rápido: a B-tree
O índice é guardado numa estrutura de dados chamada B-tree, uma árvore balanceada (o B é de balanced, e tree é árvore). Os valores ficam ordenados e distribuídos em galhos, e a busca vai descendo pela árvore comparando.
Imagina um índice com os ids de 1 a 16, e você quer o 6. No topo está o 9, e como o 6 é menor que 9, a busca vai para a esquerda. No próximo nó está o 5, o 6 é maior ou igual e ela vai para a direita. Aí ela chega na folha com os ids de 5 a 8, que é onde a informação de fato está. A busca não passa pelos ids de 9 a 16 nem pela folha de 1 a 4, faz um caminho só, de cima para baixo.
É por isso que buscar o id 1 ou o id 50000 leva o mesmo tempo. Como a árvore é balanceada, o caminho do topo até o valor tem praticamente o mesmo número de passos para qualquer id, e por isso a busca não fica mais lenta quando o valor procurado é maior. O índice funciona também com texto, comparando a ordem alfabética, e é assim que a busca por e-mail fica tão rápida quanto a busca por id.
Como criar um índice com CREATE INDEX
A sintaxe é CREATE INDEX, o nome do índice, ON, a tabela e, entre parênteses, a coluna. O nome pode ser qualquer um que ainda não exista no banco, mas vale seguir um padrão, e o que eu uso é idx_tabela_coluna, porque o índice não é da tabela, é de uma coluna da tabela.
A busca por created estava fazendo SCAN e levando uns 80 ms. Se essa é uma busca que você faz com frequência, o ideal seria criar um índice:
CREATE INDEX "idx_users_created"
ON "users" ("created");Numa tabela com quase 880 mil linhas, a criação leva um tempinho (por volta de 600 ms no meu caso). Depois de criado, a mesma busca cai para cerca de 1 ms, igual à busca por id ou por e-mail, e o plano mostra o índice novo:
EXPLAIN QUERY PLAN
SELECT * FROM "users"
WHERE "created" = '2028-11-25 20:43:59';
-- SEARCH users USING INDEX idx_users_created (created=?)O índice não serve só para igualdade. Como os valores ficam ordenados na árvore, uma comparação de faixa também aproveita:
EXPLAIN QUERY PLAN
SELECT * FROM "users"
WHERE "created" > '2028-11'
LIMIT 50;
-- SEARCH users USING INDEX idx_users_created (created>?)Essa consulta demora um pouco mais que a de valor exato, porque agora ele precisa trazer 50 linhas e não uma, mas continua usando o índice. Pelo mesmo motivo, o índice ajuda no ORDER BY. Sem índice na coluna, o SQLite lê tudo e monta uma árvore temporária só para ordenar, e o plano avisa com USE TEMP B-TREE FOR ORDER BY. Com o idx_users_created, os dados já estão em ordem dentro do índice e a etapa de ordenação some:
EXPLAIN QUERY PLAN
SELECT * FROM "users"
ORDER BY "created"
LIMIT 50;
-- SCAN users USING INDEX idx_users_createdEsse é um SCAN que percorre a tabela na ordem do índice, sem precisar ordenar nada depois.
No JOIN o raciocínio é o mesmo. O banco de teste tem uma tabela certificates, com os certificados emitidos, e cada certificado guarda na coluna user_id o id do usuário que o recebeu. Quando você junta certificates com users usando ON users.id = certificates.user_id, o SQLite pega cada linha de uma tabela e procura a linha correspondente na outra pela coluna do ON. Se essa coluna tem índice, ou é a chave primária como o id de users, cada procura é um SEARCH que desce a B-tree. Sem índice, cada uma dessas procuras teria que ler a outra tabela inteira (ou o SQLite monta um índice temporário só para aquela consulta, o que também custa), e numa tabela com 17 milhões de certificados isso multiplica o problema do SCAN pelo número de linhas. Por isso a coluna usada no ON costuma ser a primeira candidata a ganhar um índice.
CREATE UNIQUE INDEX
Se você colocar UNIQUE entre CREATE e INDEX, o índice passa a recusar valor repetido, e qualquer INSERT com um valor que já existe dá erro. É o mesmo índice que o SQLite cria sozinho quando você declara a coluna como UNIQUE no CREATE TABLE, só que adicionado depois.
CREATE UNIQUE INDEX "idx_users_email2"
ON "users" ("email2");Como o email2 é uma cópia do email, os valores já são únicos e o índice é criado sem erro. Se a coluna tivesse algum valor repetido, o CREATE UNIQUE INDEX falharia, e você teria que resolver as duplicatas antes.
Listando os índices de uma tabela
Todo índice, criado por você ou automático, fica registrado na tabela sqlite_schema. Ela guarda o tipo, o nome, a tabela a que pertence e o SQL usado para criar cada coisa do banco, e como é uma tabela normal, dá para filtrar só os índices:
SELECT * FROM "sqlite_schema"
WHERE "type" = 'index';Os automáticos aparecem com nomes como sqlite_autoindex_users_1 (o do UNIQUE do e-mail), e os seus aparecem com o nome exato que você escreveu. Para ver os índices de uma tabela com mais detalhe, existe o PRAGMA index_list, que recebe o nome da tabela como string, e o PRAGMA index_info, que recebe o nome do índice e mostra as colunas dele:
PRAGMA index_list('users');
PRAGMA index_info('sqlite_autoindex_users_1');Covering index e o SELECT *
Você provavelmente já ouviu que não é bom usar SELECT * e que o certo é pedir só as colunas que você precisa. Um dos motivos é o covering index.
Quando o SQLite desce a B-tree do índice de e-mail e chega na folha, ela não tem só o e-mail. Ela tem também o rowid da linha, que nessa tabela é o próprio id (toda coluna INTEGER PRIMARY KEY vira o rowid). Se você pediu SELECT *, ele pega esse id na folha e faz uma segunda busca, agora na tabela principal, para buscar o resto das colunas. Se você pediu só id e email, a informação já está toda ali e a segunda busca não acontece.
EXPLAIN QUERY PLAN
SELECT * FROM "users"
WHERE "email" = 'lara.pereira6863@example.com';
-- SEARCH users USING INDEX sqlite_autoindex_users_1 (email=?)
EXPLAIN QUERY PLAN
SELECT "id", "email" FROM "users"
WHERE "email" = 'lara.pereira6863@example.com';
-- SEARCH users USING COVERING INDEX sqlite_autoindex_users_1 (email=?)| id | |
|---|---|
| anajulia.carvalho7153@example.com | 3 |
| gael.melo93@example.com | 2 |
| mariaalice_xavier2895@example.com | 4 |
O COVERING no plano quer dizer que o índice sozinho cobriu a consulta. No tempo, a diferença é pequena, de cerca de 1 ms para meio milissegundo, porque as duas buscas são rápidas, mas uma busca só é sempre mais rápida que duas. Por isso eu evito o * quando não preciso de todas as colunas, já que as que você precisa podem estar dentro de algum índice.
Índice composto no SQLite
Um índice composto é um índice de mais de uma coluna. A tabela de aulas concluídas tem uma chave primária composta, e por isso já ganhou um índice automático com as três colunas (estrutura resumida):
CREATE TABLE "lessons_completed" (
"user_id" INTEGER NOT NULL,
"course_id" INTEGER NOT NULL,
"lesson_id" INTEGER NOT NULL,
-- outras colunas
PRIMARY KEY ("user_id", "course_id", "lesson_id")
);| user_id | course_id | lesson_id | completed |
|---|---|---|---|
| 1 | 1 | 1 | 2029-08-03 03:15:11 |
| 1 | 1 | 2 | 2029-08-04 08:30:04 |
| 1 | 1 | 3 | 2029-08-06 18:13:22 |
Buscar as aulas concluídas de um usuário usa esse índice, como esperado. Agora, buscar as aulas concluídas de um curso faz SCAN na tabela de 75 milhões de linhas (coloquei um LIMIT só para não travar a minha máquina):
EXPLAIN QUERY PLAN
SELECT * FROM "lessons_completed"
WHERE "user_id" = 1;
-- SEARCH lessons_completed USING INDEX sqlite_autoindex_lessons_completed_1 (user_id=?)
EXPLAIN QUERY PLAN
SELECT * FROM "lessons_completed"
WHERE "course_id" = 1
LIMIT 200;
-- SCAN lessons_completedVocê pode estar pensando que o course_id está dentro do índice, então ele deveria ser usado. Está, mas no índice composto a ordem das colunas importa. O índice é ordenado primeiro por user_id, depois por course_id dentro de cada usuário e depois por lesson_id. Se a busca não usa a primeira coluna, o índice não funciona. Usando user_id, ele continua aproveitando o índice para course_id e para lesson_id.
A ordem em que as condições aparecem no WHERE não faz diferença. O que conta é a primeira coluna do índice estar na consulta:
EXPLAIN QUERY PLAN
SELECT * FROM "lessons_completed"
WHERE "course_id" = 1
AND "user_id" = 1;
-- SEARCH lessons_completed USING INDEX sqlite_autoindex_lessons_completed_1 (user_id=? AND course_id=?)Se você não tivesse definido a chave primária composta na criação da tabela, criaria o mesmo índice à mão, listando as colunas na ordem em que elas vão ser usadas:
CREATE INDEX "idx_lc_user_course_lesson"
ON "lessons_completed" ("user_id", "course_id", "lesson_id");Nessa tabela ele não faz sentido, porque é uma cópia do índice automático que já existe. Se você precisa buscar com frequência só por course_id, o caminho é outro índice que comece por course_id.
Índice parcial
O índice parcial é um índice com um WHERE na criação, e só as linhas que passam nessa condição entram nele. Ele fica menor, ocupa menos espaço e é ainda mais rápido, mas só é usado quando a consulta tem a mesma condição.
Vamos dizer que você busca usuários pelo nome, mas só os vitalícios. Os outros você quase nunca procura por nome, então não precisa deles no índice:
CREATE INDEX "idx_users_name_vitalicio"
ON "users" ("name")
WHERE "vitalicio" = 1;| name | id |
|---|---|
| Gael Melo | 2 |
| Lara Moraes | 6 |
O nome do índice cita o vitalicio só para lembrar da condição. A coluna indexada é name, e o vitalicio é o filtro. Uma busca só pelo nome ignora esse índice e faz SCAN, levando uns 80 ms. Com a condição do índice na consulta, ele entra em ação:
EXPLAIN QUERY PLAN
SELECT * FROM "users"
WHERE "name" = 'Ana Júlia Carvalho';
-- SCAN users
EXPLAIN QUERY PLAN
SELECT * FROM "users"
WHERE "name" = 'Ana Júlia Carvalho'
AND "vitalicio" = 1;
-- SEARCH users USING INDEX idx_users_name_vitalicio (name=?)O custo do índice e quando criar
O primeiro custo do índice é espaço. Para medir, o banco que eu testei tinha uma tabela de produtos em que a coluna sku, o código de cada produto, ficou de propósito sem índice e sem UNIQUE (estrutura resumida):
CREATE TABLE "products" (
"id" INTEGER PRIMARY KEY,
"sku" TEXT
-- outras colunas: nome, preço, estoque e data de criação
);| id | sku | name | price | stock |
|---|---|---|---|---|
| 1 | CSYIUTA7YYGZ | Pizza Ergonômico de Metal | 64974 | 0 |
| 2 | UDCY3PCPCP3D | Sabonete Licenciado de Metal | 165189 | 73 |
| 4 | GCR1BGBZYPB4 | Sabonete Ergonômico de Granito | 127200 | 139 |
Buscar um produto pelo sku faz SCAN no milhão de produtos. Antes de criar o índice, o arquivo do banco tinha 5.772 MB:
EXPLAIN QUERY PLAN
SELECT * FROM "products"
WHERE "sku" = 'UDCY3PCPCP3D';
-- SCAN products
CREATE INDEX "idx_products_sku"
ON "products" ("sku");Depois do CREATE INDEX, o arquivo foi para 5.794 MB, ou seja, cresceu cerca de 22 MB. É pouco perto dos quase 5,8 GB do banco, mas cresceu, e quanto maior a tabela e o dado que vai no índice, mais ele cresce. Um sku de 12 caracteres ocupa pouco, e um índice numa coluna de texto longo ocuparia bem mais.
| Momento | Tamanho do arquivo |
|---|---|
Antes do CREATE INDEX | 5.772.947.456 bytes |
Depois do CREATE INDEX | 5.794.041.856 bytes |
| Diferença | 21.094.400 bytes (~21 MB) |
O segundo custo é escrita. Toda vez que você faz um INSERT, um UPDATE ou um DELETE, o SQLite atualiza todos os índices daquela tabela, igual ao livro que ganhou páginas novas no capítulo 10. Não é um impacto enorme, mas é o motivo de você não poder sair indexando todas as colunas para deixar a tabela “hiper rápida”.
Mas André, onde eu devo criar os índices? A ideia é bem simples, geralmente eu crio eles depois que eu já tenho boa parte do meu Back End planejado e eu já consigo entender quais serão as principais consultas (SELECT) que eu vou fazer ao banco de dados. E não precisa se preocupar, depois em produção você pode sempre analisar as QUERIES mais lentas e avaliar se um índice seria o ideal para melhor a performance das mesmas.
Outra coisa a pesar é a cardinalidade, que é o quanto os valores de uma coluna são únicos, tenha ela UNIQUE ou não. O e-mail tem cardinalidade máxima, porque não existem dois usuários com o mesmo. O primeiro nome tem bem menos, já que milhares de pessoas podem se chamar Ana, e uma coluna como vitalicio, que só guarda 0 ou 1, tem cardinalidade baixíssima, e um índice nela quase não ajuda, porque cada valor ainda aponta para centenas de milhares de linhas. Dá para medir dividindo a quantidade de valores distintos pelo total de linhas:
SELECT (1.0 * COUNT(DISTINCT "sku") / COUNT(*)) AS "card"
FROM "products";
-- 0.999894
SELECT (1.0 * COUNT(DISTINCT "vitalicio") / COUNT(*)) AS "card"
FROM "users";
-- 0.0000022749O sku fica quase em 1 (alguns códigos se repetem, porque a coluna não tem UNIQUE) e o vitalicio fica perto de zero. 1 é a cardinalidade máxima e 0 a mínima. Quanto maior a cardinalidade, maior é a performance da consulta daquela coluna quando um index for adicionado.
| Coluna | Valores distintos | Cardinalidade |
|---|---|---|
products.sku | 999.894 | 0,999894 |
users.vitalicio | 2 | 0,0000022749 |
Se um índice não estiver ajudando, ou se você só quer testar a diferença, você pode remover o mesmo com DROP INDEX.
DROP INDEX "idx_users_name_vitalicio";Depois disso a busca por nome dos vitalícios volta para os 80 ms. Só tem um detalhe, o arquivo do banco não diminui. O SQLite marca o espaço que o índice ocupava como livre para ser reaproveitado, mas o arquivo continua do mesmo tamanho até você rodar o VACUUM, que reconstrói o banco e devolve esse espaço.
Se você ainda está no começo com SQL, vale ver antes os comandos SQL mais usados no SQLite, porque o índice só faz sentido quando você já sabe quais consultas o seu sistema faz.